
Black Friday 2026: Seu Site Aguenta o Dia em que Mais Precisa Vender?
Na Linux Solutions, o site é a nossa principal ferramenta de aquisição de leads. Antes de conversar com o comercial, pedir uma cotação ou conhecer uma solução, boa parte das pessoas passa por ele. Isso significa que, se uma página demora para carregar, um formulário deixa de funcionar ou o site fica indisponível, não enfrentamos apenas uma falha técnica: criamos uma barreira exatamente no caminho de quem estava interessado em falar conosco.
Para um e-commerce, esse impacto é ainda mais direto. O cliente viu a campanha, clicou no anúncio, encontrou o produto e decidiu comprar. Se o catálogo não abre, o carrinho trava ou o pagamento falha, todo o investimento feito para atrair aquela pessoa pode terminar em uma tela de erro. Em outras palavras, é uma venda potencial perdida, mesmo depois de todo o investimento feito para levar o cliente ao e-commerce.
Por isso, decidimos falar sobre o tema Black Friday neste artigo. A Black Friday de 2026, que acontecerá em 27 de novembro, já deve estar no radar da sua equipe por agora, quando ainda existe tempo para conhecer o ambiente, corrigir gargalos, testar respostas e definir o que a equipe fará quando o volume de acessos aumentar.
O acesso só tem valor quando o caminho inteiro funciona
O primeiro passo é olhar para o site como o cliente enxerga, e não apenas como um conjunto de servidores operantes. Entre o clique em um anúncio e a confirmação de uma compra ou de um contato existem DNS, conexão, firewall, aplicação, banco de dados, armazenamento, APIs, gateway de pagamento, estoque, serviço de e-mail e outras integrações.
O site pode estar online, mas isso não significa que esteja funcionando corretamente em todas as etapas da jornada do cliente. A página inicial pode abrir enquanto a busca não encontra produtos, o catálogo demora para carregar, o carrinho falha ou o formulário confirma um envio que nunca chega ao comercial. Para a infraestrutura, pode ser uma indisponibilidade parcial. Para o cliente e para a empresa, é simplesmente uma compra ou um contato que não aconteceu.
Antes da Black Friday, a equipe precisa percorrer e testar a jornada de compra inteira, pois é ela que gera resultados para a empresa.
- O domínio e as páginas abrem normalmente?
- A busca, os filtros e o catálogo respondem no tempo esperado?
- Imagens, preços e informações de estoque são carregados corretamente?
- Carrinho, cálculo de frete, pagamento, formulário e botões de contato funcionam?
- As integrações externas completam a operação?
- O pedido ou lead chega ao sistema e à equipe responsável?
Esse mapeamento define o que realmente precisa ser acompanhado. Para um e-commerce, checkout e pagamento podem ser mais críticos do que a página institucional. Em uma empresa B2B, como a Linux Solutions, por exemplo, páginas de soluções, formulários e canais de contato fazem parte da principal rota de aquisição de leads. Portanto, também é necessário conhecer o comportamento normal do ambiente: quanto de CPU, memória, disco, conexões, consultas e tráfego é utilizado em um dia comum? Quais horários já apresentam lentidão? Que componentes se aproximam do limite? Essa linha de base permite reconhecer se o aumento da campanha está dentro do esperado ou se um gargalo está se formando.
Teste antes do pico e defina como a equipe vai reagir
Com o caminho crítico conhecido, o próximo passo é testá-lo sob condições próximas às da campanha. Um teste que envia milhares de requisições somente à página inicial pode dizer pouco sobre o que acontecerá quando clientes pesquisarem produtos, aplicarem filtros, consultarem estoque, adicionarem itens ao carrinho e tentarem pagar ao mesmo tempo.
Os cenários devem reproduzir jornadas reais e responder a três perguntas:
- O serviço permaneceu disponível? As etapas essenciais puderam ser concluídas?
- O desempenho continuou aceitável? O sistema respondeu, mas ficou lento a ponto de afastar o cliente?
- Onde surgiu a pressão? Aplicação, banco, armazenamento, rede ou integração se aproximaram do limite?
Além do pico de acessos, a equipe precisa ensaiar falhas plausíveis em ambiente controlado. O que acontece quando o banco fica lento, uma API externa deixa de responder, o espaço em disco se aproxima do limite ou um nó precisa sair de operação? Quem recebe o alerta, quem investiga e quem pode executar uma mudança? Em quanto tempo o serviço precisa voltar?
Uma preparação objetiva pode ser guiada por esta relação:
| Situação a verificar | Pergunta que precisa estar respondida |
|---|---|
| Aumento de latência | A equipe consegue identificar em qual etapa a lentidão começou? |
| Erro na aplicação | Existem logs centralizados e um responsável capaz de interpretar o evento? |
| Saturação de recursos | Há margem de capacidade e um plano de expansão ou redistribuição? |
| Falha de integração | É possível diferenciar um problema interno de uma indisponibilidade externa? |
| Atividade suspeita | Há registros, regras de detecção e um procedimento de resposta? |
| Perda de dados ou infraestrutura | O backup pode ser restaurado dentro da necessidade do negócio? |
Nos dias finais, mudanças não essenciais devem ser evitadas. Atualizações, novas integrações e alterações de arquitetura feitas perto da campanha podem introduzir riscos quando a prioridade deveria ser previsibilidade. O momento de descobrir que o backup não restaura, que o alerta não chega ou que ninguém sabe quem deve agir é durante o teste — não durante o pico.
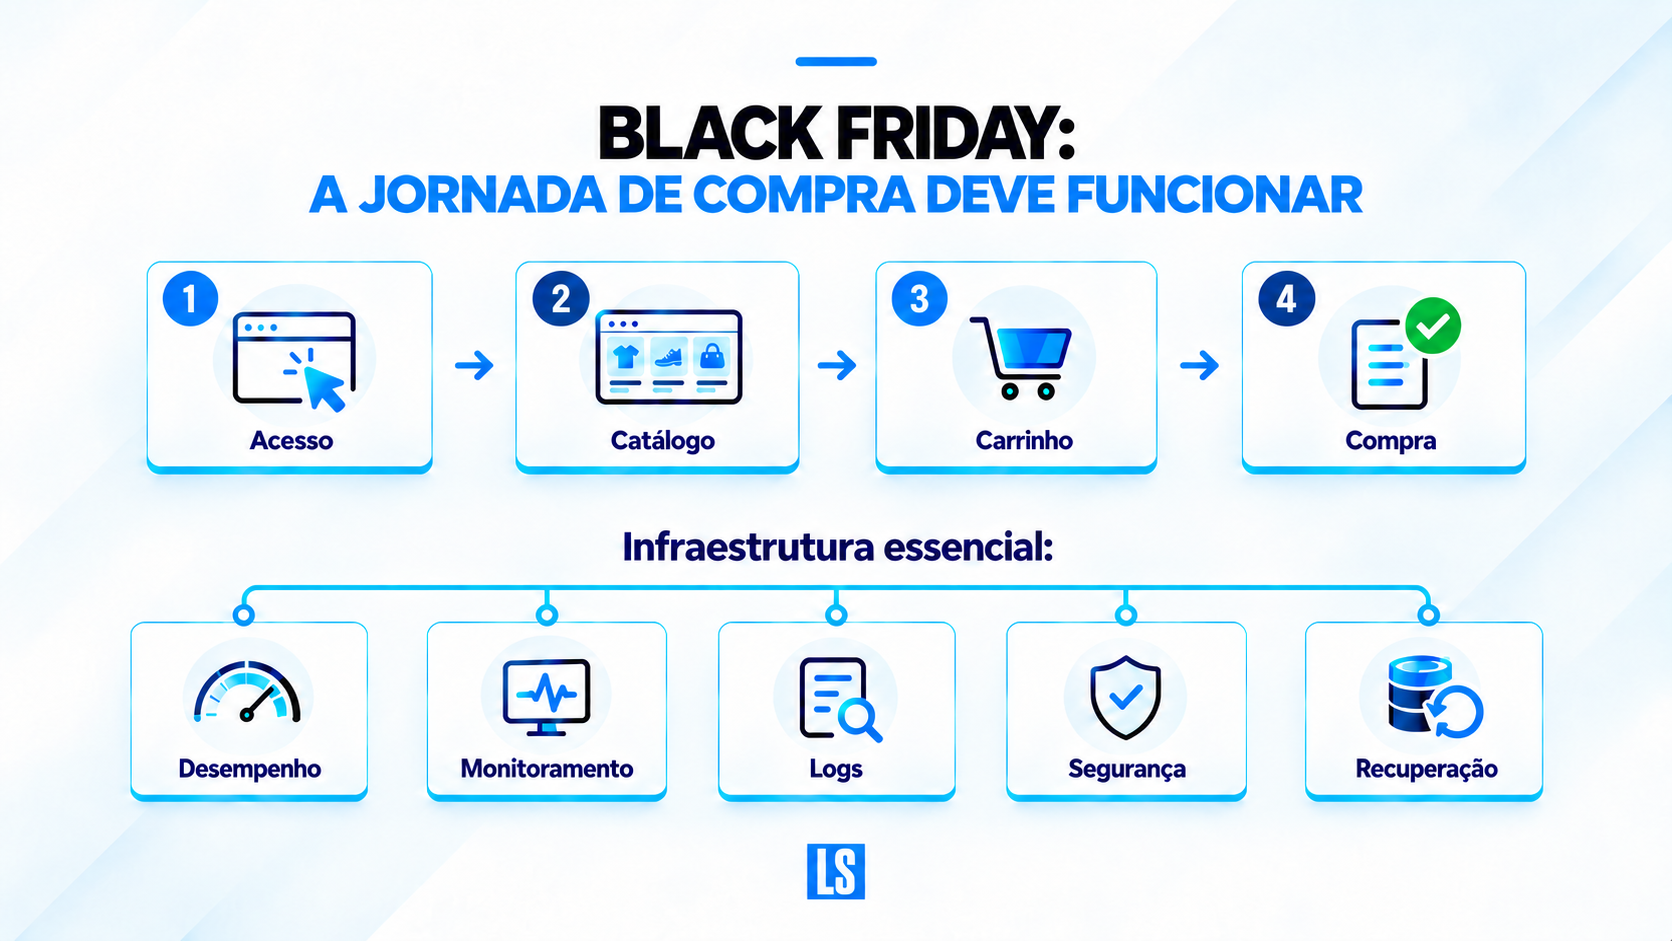
Como as soluções da Linux Solutions ajudam a preparar a operação
Nenhuma ferramenta, isoladamente, deixa um site pronto para a Black Friday. O papel das soluções é oferecer visibilidade e capacidade de reação em pontos diferentes da operação. A arquitetura correta depende do ambiente, mas algumas funções são especialmente importantes nesse período.
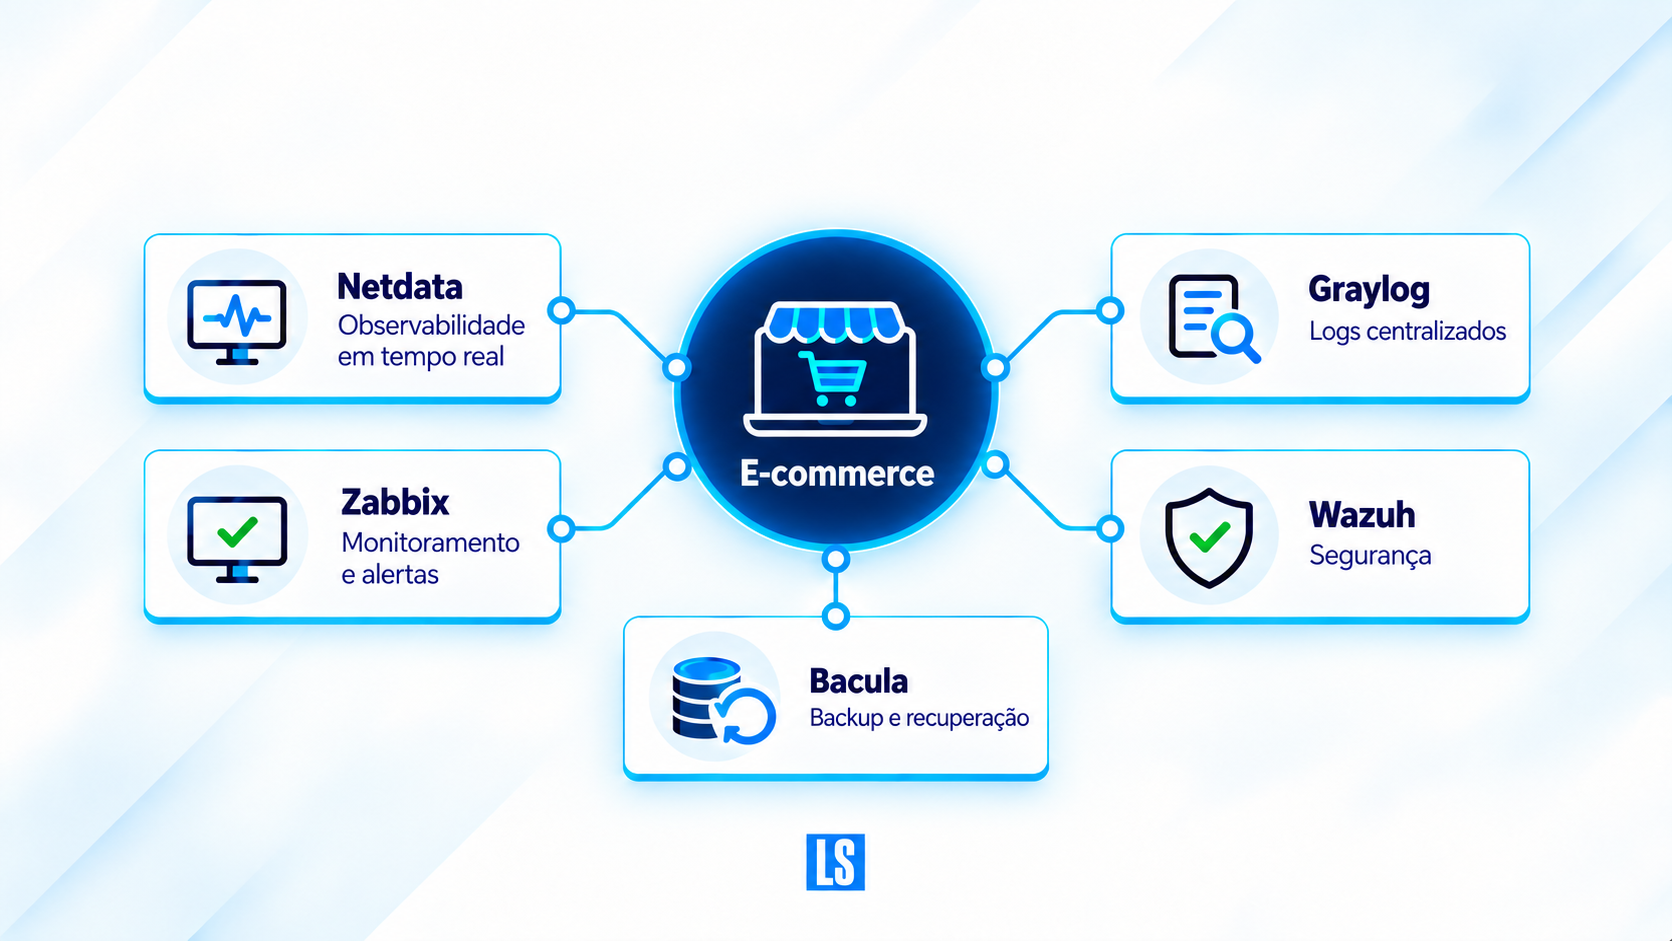
Netdata: desempenho e anomalias em tempo real
O Netdata acompanha métricas detalhadas de servidores, aplicações, containers, bancos de dados e rede. Durante testes e picos reais, ele ajuda a visualizar como CPU, memória, disco, conexões, consultas e outros indicadores se comportam segundo a segundo.
Seu diferencial está na detecção de anomalias. O Netdata utiliza modelos de machine learning para aprender o comportamento das métricas e sinalizar desvios. O Anomaly Advisor correlaciona comportamentos anormais e destaca métricas relevantes para a investigação. Na prática, isso pode ajudar a equipe a perceber que uma lentidão não veio apenas do aumento de tráfego, mas coincidiu com mudanças no banco, no armazenamento ou em determinado serviço.
A IA não garante disponibilidade nem substitui o analista. Ela reduz o espaço de investigação e oferece contexto para que a equipe chegue mais rapidamente às causas prováveis.
Zabbix: disponibilidade e validação das jornadas
O Zabbix pode acompanhar servidores, equipamentos, links, serviços e aplicações, além de executar cenários de monitoramento web por HTTP ou HTTPS.
Isso permite verificar mais do que a disponibilidade da página inicial. É possível estruturar verificações para etapas essenciais, acompanhar tempos de resposta e gerar alertas quando um serviço deixa de responder conforme o esperado. O Zabbix também ajuda a reunir a visão de infraestrutura que sustenta o site, permitindo que a equipe veja se o problema está associado a um host, link, serviço ou recurso monitorado.
Netdata e Zabbix podem ser complementares: um acompanha em profundidade o comportamento e as anomalias das métricas; o outro organiza disponibilidade, verificações e alertas sobre ativos e serviços. A escolha e a integração devem considerar o que já existe no ambiente e a capacidade da equipe.
Graylog: contexto para entender o que falhou
Quando uma página gera erro ou uma integração deixa de funcionar, métricas podem indicar o momento e o impacto, mas nem sempre explicam o motivo. O Graylog centraliza logs de aplicações, servidores, bancos, firewalls e outros componentes para pesquisa e análise.
Em vez de acessar cada servidor separadamente durante a campanha, a equipe pode consultar os registros em um ponto central e relacionar horário, aplicação, usuário, endereço de origem, mensagem de erro e serviço envolvido. Essa rastreabilidade reduz o tempo gasto procurando evidências espalhadas.
Wazuh: segurança durante o aumento de exposição
Campanhas que atraem tráfego legítimo também ampliam a exposição do ambiente. O Wazuh coleta e analisa dados de endpoints, sistemas, aplicações e dispositivos. Seus recursos incluem análise de logs, monitoramento de integridade de arquivos e detecção de vulnerabilidades.
Na preparação, ele pode apoiar a identificação de softwares vulneráveis e mudanças relevantes nos ativos monitorados. Durante a campanha, ajuda a organizar eventos de segurança e distinguir sinais que merecem investigação. Isso não elimina a necessidade de firewall, configuração segura, atualização e processos de resposta, mas acrescenta visibilidade sobre o que ocorre nos sistemas.
Bacula: recuperação quando prevenção e redundância não bastam
O Bacula pode compor uma estratégia centralizada de backup para servidores e dados críticos. Na Black Friday, o ponto mais importante não é apenas possuir cópias: é saber o que está protegido, qual é a frequência, por quanto tempo os dados são retidos e em quanto tempo a operação pode ser recuperada.
Por isso, a restauração deve ser testada antes da campanha. Um backup existente, mas lento, incompleto ou nunca validado, não oferece a previsibilidade necessária para um ambiente que depende de vendas e contatos online.
A Black Friday torna fragilidades mais visíveis porque concentra acessos e expectativas em pouco tempo. Para e-commerces, catálogos online e empresas que geram leads pelo site, a preparação se resume a conhecer a jornada crítica, testar o ambiente e dar à equipe recursos para detectar, entender e recuperar falhas.
A Linux Solutions pode avaliar o cenário e apoiar a implantação integrada de monitoramento, observabilidade, logs, segurança e backup com soluções open source adequadas à operação.
Pontos Importantes
Quando devo começar a preparar a infraestrutura para a Black Friday?
O ideal é começar com semanas de antecedência. Mapear dependências, estabelecer uma linha de base, testar jornadas, corrigir gargalos e validar recuperação exige tempo. Quanto mais perto da campanha, menor a margem para mudanças seguras.
Monitorar se o site está online é suficiente?
Não. A página inicial pode responder enquanto busca, catálogo, carrinho, pagamento ou formulário falham. O monitoramento deve acompanhar as jornadas que geram vendas ou leads, além da infraestrutura que as sustenta.
Netdata e Zabbix fazem a mesma coisa?
Eles possuem áreas de sobreposição, mas podem assumir papéis complementares conforme a arquitetura. Zabbix é amplamente usado para disponibilidade, infraestrutura, alertas e cenários web. Netdata oferece métricas detalhadas em tempo real, detecção de anomalias e recursos de investigação auxiliada por IA. A necessidade de usar um ou ambos depende do ambiente.
A IA do Netdata impede que o site saia do ar?
Não. Ela pode ajudar a detectar e correlacionar comportamentos anormais, mas não substitui capacidade adequada, testes, arquitetura resiliente, processos de resposta ou análise humana.
Ter backup garante recuperação durante a campanha?
Não. É necessário saber o que está protegido, com que frequência, em quanto tempo pode ser restaurado e se a restauração realmente funciona. Um backup nunca testado ainda representa incerteza operacional.

Governo Digital, LGPD, PPSI, PPSI 2.0, Segurança da informação, Setor Público